

高通在2026骁龙峰会上正式发布了两款旗舰移动平台:第六代骁龙8至尊版和第六代骁龙8超级至尊版。外界此前对超级至尊版这颗更高定位芯片的命名猜测持续了数月,普遍认为它会叫“骁龙8 Elite Gen 6 Pro”,但高通给出的最终答案干脆利落:没有Pro,只有Extreme,全称是骁龙8 Elite Extreme Gen 6。Pro并不属于骁龙移动平台的命名体系,而“Extreme”这个后缀对高通而言并不陌生。2025年9月发布的骁龙X2 Elite Extreme,就是标准Elite之上的新级别,Elite本身则是原X系列产品线中的顶级芯片。所以,第六代骁龙8超级至尊版采用Extreme命名,是高通旗舰分层逻辑的一脉相承。
名字的事讲完了,真正值得追问的是另一个问题:这颗芯片的超大核主频首次突破5GHz,它是怎么做到跑得快的同时又不烫手的?
5GHz的散热难题,答案藏在封装里
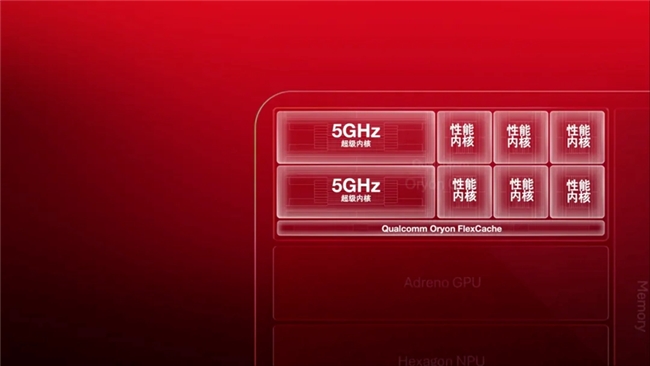
5GHz是这一代骁龙超级至尊版CPU最受瞩目的数字。它由2颗最高5.0GHz的Prime超级内核和6颗最高4.0GHz的Performance性能内核组成,高通官方称这是首个迈过5GHz门槛的移动CPU。频率越高、功耗越大,这是物理规律。高通的做法不是回避,而是从封装层面给出了一个物理层面的解法。
骁龙8 Elite Extreme Gen 6采用了Offset PoP(偏移封装) 方案。过去约10年,高通在8系平台上一直采用传统PoP封装,将LPDDR内存垂直堆叠在SoC上方。这种结构下内存布线无需经过主板,但内存本身也成了一层隔热屏障,散热材料很难直接接触处理器封装的核心区域。
Offset PoP的做法是:把内存从SoC上方移到一侧,在芯片顶部腾出空间放置导热材料,形成一条通往手机散热模组、热阻更低的传热路径。高通高级副总裁兼手机业务总经理Chris Patrick在骁龙峰会上说得很直白:“更快将热量导出、让SoC维持更低温度,系统就能在最高性能区间停留更久。”他将这颗芯片比作“赛车引擎”——日常功耗较低,但在需要时可以释放极高的峰值性能。
2nm:功耗降低的物理基础
封装解决的是“热量能不能导出去”,制程解决的是“热量能不能少产生”。第六代骁龙8超级至尊版采用台积电N2P(2nm增强版)工艺。与N3E相比,N2P在相同速度下功耗可降低约36%,相同功耗下性能可提升最高18%。高通官方确认,这一代CPU能效较上代提升37%,GPU能效提升40%。
37%的功耗降幅放在手机这种散热和电池都有硬上限的设备里,意味着从物理层面拓宽了功耗天花板。过去几年旗舰机在高负载场景下频繁发热降频的问题,第一次有了从底层被根治的可能。
CPU:5GHz不等于高功耗
制程提供了功耗红利,但架构决定了红利会不会被浪费。Oryon CPU围绕功耗做了两件关键的事。
第一,独立时钟域。每个核心拥有独立的时钟域,可以单独进行频率扩展。系统根据任务轻重精准给特定核心调频——刷微博时只有能效核低频运转,打开App时超大核单独拉升。需要多少给多少,不多给一度电。
第二,FlexCache缓存架构。超级至尊版的Oryon CPU配备16MB Oryon FlexCache统一缓存,所有核心共享一个缓存池,使数据驻留在缓存中,减少对系统内存的访问。Chris Patrick在采访中特别强调,跨代升级的核心驱动力来自微架构演进,包括新的缓存结构FlexCache、SME引擎,以及核心间一致性互连接口等。制程负责把功耗“省下来”,架构确保省下来的功耗不会被浪费。
GPU:频率涨了,功耗反而降了
新一代Adreno GPU的频率从1.2GHz提升至1.45GHz,但功耗在多个层面实现了降低。
超级至尊版的GPU性能提升44%,能效提升40%。这背后有两项关键硬件。18MB Adreno HPM片上高速显存,让渲染过程中的中间数据直接存在芯片内部,无需反复前往系统内存。作为对比,标准版的HPM容量为12MB。Adreno Matrix Cores首次将AI专用矩阵核心引入图形管线,超级至尊版独享Matrix Cores和Adreno Neural Fusion技术,AI超分辨率和帧生成可以直接在图形渲染管线内部完成,功耗相比上一代方案最高可节省40%。
GPU能效的进步在实际测试中表现明显。极客湾的前瞻上手数据显示,GPU能效进步明显,特别是低频部分持平A20 Pro;游戏实测帧率和功耗都不输A20 Pro,相比骁龙8 Elite Gen 5提升不小。在小米18 Pro Max的评测中,半小时《王者荣耀》120帧模式下平均帧率119.7fps,平均功耗约3.49W;《崩坏:星穹铁道》平均帧率59.15fps,平均功耗5.63W,没有形成持续性降频区间。
NPU:让大模型推理不再成为电量杀手
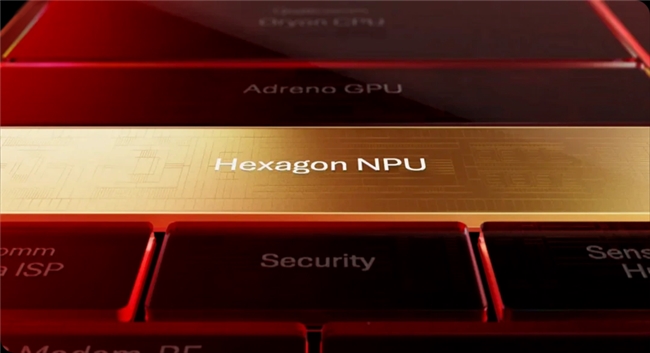
端侧大模型推理有一个反直觉的工程现实:解码阶段的瓶颈往往不在算力,而在数据搬运。模型每生成一个词元,都需要读取保存对话上下文的KV缓存。如果NPU片上空间不足,数据就必须在NPU与主内存之间频繁搬移,推高时延和功耗。
超级至尊版的Hexagon NPU将共享内存容量较前代增加50%,让模型状态、上下文信息和KV缓存存储在更靠近加速器的位置,减少对外部内存的访问频次。NPU性能提升35%,每瓦性能提升33%。
在模型层面,超级至尊版支持在终端侧运行300亿参数的MoE模型,每次生成词元仅激活约30亿个被路由选中的参数,减少实际计算负载和内存带宽需求。配合从闪存到内存的智能加载机制,以及LPDDR6和UFS 5.0的存储组合,模型权重可以从闪存高效加载,通过存储与计算协同减少对运行内存的持续占用。
最后
第六代骁龙8超级至尊版的功耗优化,不是靠单一模块的修补,而是一套从封装到制程、从架构到数据的系统级工程。Offset PoP封装把内存挪到一侧、芯片顶部腾出散热通道,让峰值性能持续时间翻倍;2nm N2P工艺从物理层面把功耗降下来;Oryon CPU的独立时钟域和FlexCache确保算力精准分配、数据就近驻留;Adreno GPU的18MB HPM和Matrix Cores把图形渲染的功耗压到更低;Hexagon NPU的共享内存扩容50%和MoE架构让大模型推理不再成为电量杀手。芯片的竞争,正在从谁能跑得更快转向谁能让每一毫瓦都物尽其用,而这一次骁龙8 Elite Extreme Gen 6将物尽其用做到了极致。


